2026年秋LLMはここまで来た。 ローカルLLMに手足をつける?! ClaudeDesktopのようなコード開発支援ツールに仕立ててみる

2026年秋時点で、ローカルLLMはツール呼び出しにより「手足」を持たせやすくなっている。ファイル書き込みとコード実行の簡単な仕組みを組んだところ、Gemma4がランダムCSVの生成とソートをほぼ自律的に完了。OpenCodeやGoose、MCPなどの既存ツールと組み合わせれば、さらに実用的なローカルコーディングエージェントが作れる状況だ。

2026年秋LLMはここまで来た。

ローカルLLMに手足をつける?! Claude Desktopのようなコード開発支援ツールに仕立ててみる。 Visual Studio Code + Clineで試してみて、重くてほぼ使い物にならなかったので半分かきらめていたが、自分で作ってみたほうが軽くできるのでは?ということで試してみた。

2026年秋、ローカルで動くLLMは「ただのチャット」から、かなり実用的な「作業者」に近づいてきた。

特にGoogleのGemma 4シリーズ(例: gemma4:26b、MoEでアクティブパラメータ約4B)は、ツール呼び出し(function calling)を標準でサポートし、長コンテキスト(大きいサイズで256K)、コーディング能力、マルチモーダル対応を備えている。Ollamaやllama.cpp、LM Studio経由で、比較的手軽に動かせるサイズ感だ。

ここに「手足」を付ける——つまり、ファイルの読み書きやPython実行などのツールを与えて、モデル自身にコードを書いて実行させるループを組むと、Claude DesktopやClaude Code、OpenCodeのようなコーディング支援エージェントに近い振る舞いが、ローカルでも再現できる。

実際に簡単な仕組みを組んで試してみたところ、想像以上にすんなり動いた。

簡単な実験:ランダムCSV生成とソート

使用モデルは gemma4:26b。ツールとして「ファイルを書く(write_file)」と「Pythonを実行する(run_python)」を用意しただけの、かなり素朴なエージェントループだ。

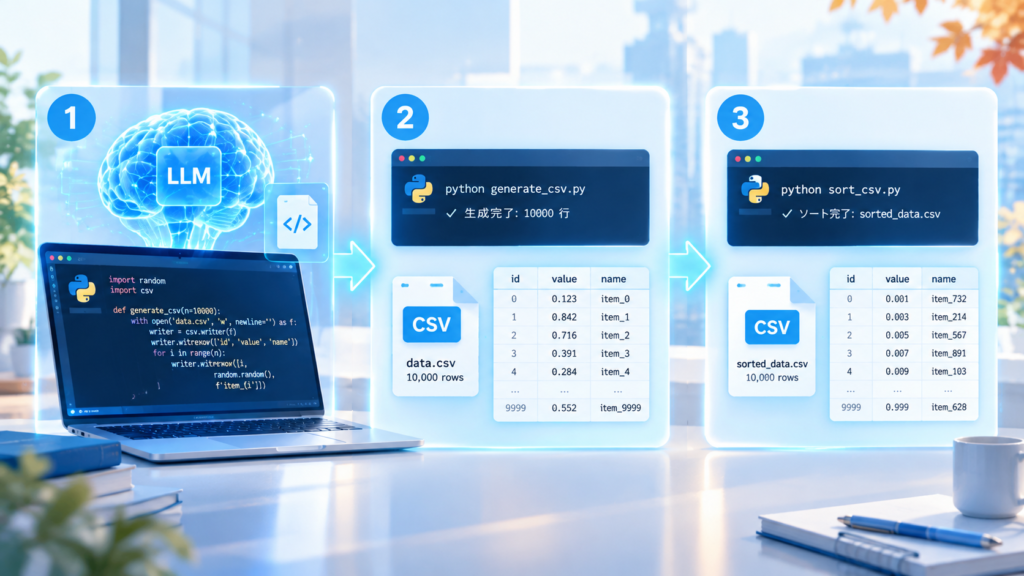
AIデータ処理ワークフロー
AIデータ処理ワークフロー

依頼1:ランダムな2列CSVを1万行作る

ユーザーの指示:

2項目の値の、csvファイルを作成するpythonコードを作成し実行してください。
コード名 randm.py、生成するファイル名 rand2026.csv。
10025,44557
10256,55455
…
というような、2元の整数の組のファイルです。
それぞれの数字は 1~99999999 の間の整数でランダム。これを1万行書き出す。

モデルはコードを書き、ファイル名を一度間違えたものの自分で修正し、実行した。結果:

Successfully created rand2026.csv with 10000 rows.

中身を確認したところ、範囲内のランダムな整数ペアが1万行、妥当に生成されていた。

依頼2:1列目でソートして別ファイルに出力

続けて:

rand2026.csv の1項目目の数値で、行ソートするプログラム(sort_gemma4.py)を作成し rgema.csv にソート結果を出力してください。

モデルは csv モジュールを使い、1列目を整数として比較してソートするコードを書き、実行。

Successfully sorted rand2026.csv and saved to rgema.csv

ソート結果も正しい内容になっていた。一連の作業はおよそ10分程度で完了。

モデルが「コードを書いて→実行して→結果を確認して次へ進む」という流れを、ほぼ自律的にこなした。最初はファイル名を少し間違えたが、すぐに直している。これは「手足」がちゃんと機能している証拠だ。

なぜこれが「厳しい」のか

この程度の仕掛けは、ツール呼び出しをサポートしているモデル(Gemma 4、Qwen系、Llama系など)と、Ollamaなどのランタイムがあれば、比較的短時間で組める。

すでにオープンソースのコーディングエージェントは充実している:

  • OpenCode:ターミナル中心、75以上のプロバイダ対応、ローカルモデルも可能。Claude Codeに近い体験をオープンに。
  • Goose(Block発、Apache-2.0):MCPベースの拡張性が高く、完全オフライン運用も可能。
  • Aider:Git統合が強く、軽量で小さなモデルでも動きやすい。
  • Cline や各種MCPサーバー:Claude Desktopにファイルシステムやターミナル、デスクトップ操作を追加する仕組みが成熟している。

Ollamaには ollama launch claude --model gemma4:... のような起動支援もあり、Claude Code自体をローカルモデルで動かす道も広がっている。MCP(Model Context Protocol)経由でファイル操作やコマンド実行を安全に(あるいは許可制で)行える環境が整いつつある。

つまり、「それなりに能力がある人が作ったら、すぐにローカルLLMでも高度なことができる」状態に、すでになっている。コードを書いて実行し、結果を見て次の手を打つ——このループさえ回せれば、CSV生成のような単純作業だけでなく、より複雑なデータ処理やスクリプト作成、反復的な検証もこなせる。

現実的な限界と注意点

もちろん、クラウドの最上位モデル(ClaudeやGPT系の最新)と比べると差はある。

  • ツール呼び出しの安定性や、長いコンテキストでの一貫性はまだモデル依存。
  • 速度はハードウェア次第。GPU/Apple Siliconでそこそこ速くても、複雑な多段思考は時間がかかる。
  • コード実行は強力な分、サンドボックスや許可確認が必須。不用意に広い権限を与えるとリスクがある。
  • 大規模なコードベースの理解や、長期的なプロジェクト管理では、まだクラウド側に分があることが多い。

それでも、「自分のマシンだけで、データを外に出さずに、コストを気にせず作業できる」価値は大きい。特に機密データやオフライン環境では明確な優位性がある。

おわりに

2026年秋のローカルLLMは、単に「動く」だけでなく、「手足を付ければ実用的な作業者になれる」段階に来ている。

今回の実験はごく単純なものだが、それで十分な結果が出たことが重要だ。OpenCodeやGoose、MCP対応のツールを組み合わせ、Gemma 4やQwen系のモデルを載せるだけで、Claude Desktop的な体験のかなりの部分をローカルで再現できる。

これからの競争は、「モデル単体の賢さ」だけでなく、「いかに適切な手足(ツール)と安全な実行環境を組み合わせるか」に移っていくのだろう。ローカルでここまでできるなら、クラウドとの使い分けやハイブリッドな運用も、より現実的になってきた。

参考にした操作の記録は、ランダムCSVもソート結果も妥当な内容で、一連の作業が短時間で完了したことを示している。少し複雑な実装でも、同じ仕組みで試す価値は十分ありそうだ。

しかし、ここまでくると悪用も容易にできそうな状態になっていることがよく分かる。攻めと守りでは、攻めのほうが有利である。わずかでも穴を見つければよいからだ。守る側は穴がないように作り上げる必要があるが、それはなかなか難しい。

破られたことを早期に検知し、被害を抑え、いかに早く復旧するかという世界に変わっていくかもしれない。ただしそれは、一通りしっかり守る仕掛けを用意してからの話だろう。

似たような話は昨今の水害にも通じるかもしれない。少しでも穴があると堤防は崩壊する。いかに避けにくいか、早く復旧するかが重要だが、同じことが起こらないよう、最適なコストで復旧・強化していくことが求められる。


関連記事

PHP2Shell緊急対応の記録(2)事前情報を読む――23時の公開に備えたhsBoxの一夜

PHP2Shell対応の記録・第2話。第1話以降の状況の更新、hsBoxの一夜、各社の「影響なし」「対応中」告知の読み方を、大手レンタルサーバーの例とともに整理します。

筆者:muller|2026年10月23日朝時点の情報です

第1話をお読みいただき、ありがとうございました。

第2話では、次の3点を書きます。第1話以降の状況の更新と補足、hsBoxの一夜、そして各社の「影響なし」「対応中」という告知をどう読むか、です。筆者は、hsBoxの情報公開をお手伝いした立場です。

1. 第1話からの更新と補足

国内の状況(22日昼時点)

  • 停止やメンテナンスを告知した組織は、22日午前の時点で、piyologの集計では211になりました。第1話の54は、21日の22時台までの数字です。
  • 主なサービスは次々に戻っています。pixivは21日23時30分にメンテナンスを終え、コドモンは22日3時22分、BASEは8時に再開しました。以上はzephel01氏のnoteの整理によります。
  • 同じnoteは、この脆弱性で侵害を受けたと公表した国内の組織は、22日12時15分ごろの時点で確認できないとしています。止めたのは「やられたから」ではなく、「やられる前に」止めたから、という整理です。

海外の状況

  • watchTowrは、修正版の公開とほぼ同じころに、実際の悪用の試みを観測したと報告しています。ただし、成功した例は観測していません。CloudflareやPatchstackも、より早い時間帯から試行を観測しています(SecurityWeek)。
  • Amazonは、公開前の10月17日に最初の試行を観測したと、Greenboneがまとめています。ニュージーランドのNCSCも、悪用の報告を把握しているとしています(Greenbone)。
  • Cloudflareは、一般への公開の約9時間前に防御を配備していました(セキュリティ対策Lab)。
  • 米CISAの悪用済み脆弱性カタログ(KEV)には、22日の時点で、2件とも掲載がありません(watchTowr)。

つまり、攻撃の試みは公開前から来ており、悪用を観測したとするベンダーも複数あります。一方で、CISAのKEVには、22日の時点でまだ載っていません。修正版を当てていないサーバーが安全という意味ではありません。

第1話への補足

首相の投稿の時刻。 第1話では「報じられました」と書いた首相の投稿は、21時55分に公式Xへ投稿されたものです。国家サイバー統括室は、その11分前の21時44分に同じ趣旨を投稿していました。どちらも、修正パッチの適用が難しければ、ウェブサイトの一時停止も有効策の一つだと述べています(INTERNET Watch)。

修正版の公開時刻。 第1話では「22時台」と書きましたが、出典によって幅があります。多くの資料や、国内事業者の告知(エックスサーバーなど)は、予告どおりの23時(14:00 UTC)としていますが、AlmaLinuxは12:59 UTC(日本時間21:59)、CERT-EUは13:30 UTC(日本時間22:30)と記しています。php.netとGHSA本体の公開時刻は、筆者はまだ特定できていません。【要確認】

当初の予定。 調整済みの公開日は、もともと22日だったとされています。漏えいを受けて1日前倒しされ、21日の公開になったと、SOCRadarなどが書いています。

2. hsBoxの一夜

事前情報を読む

最初の情報は、事前に追っていた情報から得ました。【ウォッチ対象:普段どの情報源を見ているか】筆者の経験では、重い脆弱性の公表が近づくと、事前に何かしらの気配が漏れてくるもので、見慣れてくると察しがつくようになります。

今回は、もう一つ警戒材料がありました。昨今、AIの関与が疑われる不正アクセスが相次いでいる状況です。INTERNET Watchも、AIが24時間休まず手数を増やしていることを要因とみる声が多いと書いています。今回の脆弱性との関連があったかどうかは、後の検証に委ねます。ただ、警戒すべき事前情報の一つとして頭に置いていたことは、書き残しておきます。なお、攻撃の試みは公開前から始まっていたと報告されています(上の「海外の状況」を参照)。事前情報を追う意味は、そこにもあります。

23時からの動き

  • 23時過ぎ:予告されていた23時の公開を把握していたので、確認を始めました。hsBoxで修正版のパッチを適用できるかの検証にとりかかりました。
  • 23時30分:適用できることを確認しました。ただちに情報発信の作業に移りました。
  • 【時刻】:情報を公開しました。https://x.com/hoscm2025/status/2112923979010965921

検証の開始から適用確認までは、約30分でした。【検証の内容:環境、手順、確認した項目】

なお、修正版の公開は予告より早かったとする資料もあります(上の「第1話への補足」を参照)。hsBoxの動き出しは、予告の23時を基準にしたものでした。公式の予告にも、前倒しもあり得ると書かれていました。

情報を絞って、最速で出す

情報公開で一番重視したのは、速さでした。利用者が一番知りたいのは、自分の環境が対策済みかどうかと、何をすればよいかです。そこで、載せる情報を絞って発信しました。

  • 後から伝えた情報:情報の読み取りかたについて補足情報を追加。

判定の基準については、第1話で書いたとおり、リリースとパッケージ名をセットで示す必要があります。

リリース確認後の情報公開としては早かったほうではないだろうか。引き続きよろしくお願い致します。

3. 「影響なし」「対応中」という告知をどう読むか

今回は、多くの組織が告知を出しました。利用者や取引先は、その告知を読む側に回ったことになります。筆者が気になったのは、内容の差よりも、書き方の差です。特定の組織を評価する意図はなく、公開されている告知から読み取れたことだけを書きます。

「影響なし」には、根拠と時点が必要です

  • 根拠が書かれている例があります。はてなは、はてなブログとはてなCMSがPHPを使っておらず影響を受けないと発表しました(セキュリティ対策Lab)。ニコニコは、一部のサービスについて、影響を受けない技術構成だと説明しています(zephel01氏のnote)。LegalOn Technologiesは、11時15分の更新で、複数のサービスが影響を受けないと説明しました(セキュリティ対策Lab)。
  • 確認の範囲も大事です。自社が書いたコードだけでなく、依存しているソフトウェアや機器、委託先まで見ているかどうかです。たとえばPalo Alto Networksは、自社製品のPAN-OSとPanoramaにも影響があると公表しています(セキュリティ対策Lab)。PHPを使っていないつもりでも、機器の中にPHPが入っている場合があります。また、HTMLだけのサイトでも、同じサーバーにPHPが組み込まれていれば影響を免れない、とINTERNET Watchは指摘しています。
  • 「影響なし」と「被害は確認されていない」は別の話です。前者は構成の話、後者はログなどを調べた結果の話です。両方が書かれていると、受け手は判断しやすくなります。

「対応中」には、見通しと暫定策がほしい

  • KAGOYAは、事業者側ではサイトを止めず、PHP 8.2〜8.5の修正版への更新を調整中としました。その間の暫定策として、利用者にサイトの公開停止やアクセス制限の検討を案内し、被害は確認されていないとしています(22日10時35分時点、zephel01氏のnoteによる)。
  • 一方、ConoHa WINGやお名前.comの告知は「システムの保守作業」とあり、PHPという言葉が出てきません(zephel01氏のnote、セキュリティ対策Lab)。
  • 攻撃者に情報を与えないために、書き方を絞るという考え方もあるでしょう。ただ、利用者が自分のサイトへの影響を判断するには、PHPへの対応かどうか、適用済みかどうかが読み取れるほうが動きやすいと、筆者は感じました。
  • 正直に言えば、告知の時点で適用状況や見通しが読み取れない事業者については、利用者の立場で心配になります。ただし、遅れている=怠慢とは限りません。顧客の環境が多様で、古いPHPには個別の修正が必要だからです。PHP公式は、サポートが終わった系列に通常のリリースを出していません。最小限のバックポートのソースが公開されただけです(Tenable)。そのため、エックスサーバーのように独自の修正を作る事業者や、mixhostのようにCloudLinuxの修正パッケージを使う事業者もあります。この話は第3話で扱います。

見通しを示した例:大手レンタルサーバーの告知

参考までに、レンタルサーバー大手のエックスサーバーの対応を、大まかに紹介します。

同社は、修正版の公開前から緩和措置を入れ、公開の数時間前にサービスサイトと管理画面へのアクセスを止めました。公開後は、公式の修正版や自社で作った修正を、新しいPHPから順に全サーバーへ適用しています。22日の早朝にPHP 8.2〜8.5、昼ごろに7.4〜8.1、午後の早い時間に5.6〜7.3を終えました。5.5以下は、告知の時点では検証中でした。管理画面は22日の朝から、サービスサイトは夜から、順次再開しています。

告知の良い点は、時系列を表で示し、適用が済んだ系列と済んでいない系列を分けて書いていることです。未完の部分を隠さず、利用者に追加の対策をお願いする場合があることも、先に書いています。見通しが読み取れる告知の例です。

利用者の運用管理者にとっては、その間、管理画面にも入れず、何もできない夜でした。ただ、共用サーバーのPHPは、もともと利用者が更新できるものではありません。提供者が全サーバーへ一括で、公式の修正がない古い系列まで手当てしてくれるのは、この形態の強みです。一方で、適用が終わるまでの間に不審な動きがなかったかを、アプリのログや管理者アカウントで確認することは、利用者側に残ります。

「誰が直すのか」は、立場によって変わります。共用サーバーなら提供者、VPSや自前のサーバーなら利用者です。この整理は、第3話で扱います。

受け手が告知を読むときの5つの視点

  1. PHPの脆弱性への対応だと明記されているか
  2. 適用済みか、調整中か、そもそも対象外か
  3. いつ時点の情報か
  4. 暫定策(アクセス制限など)が示されているか
  5. 被害の確認状況と、調べた範囲が書かれているか

深い考察は、状況が落ち着いてからにします。OSSのセキュリティを長く見てきた立場からの論点は、別稿でまとめる予定です。

4. 第2話のまとめ

  • 事前情報を追っていたから、23時過ぎにすぐ検証へ入れた
  • 最速で出すために、情報を絞った
  • 告知は、根拠・時点・範囲・暫定策を見て読む
  • 「誰が直すのか」で、利用者にできることが変わる

次回の第3話では、修正版が手元のサーバーに届くまでの距離を取り上げます。レンタルサーバー各社とLinuxディストリビューションの対応、サポートが終わったPHPの扱いに加えて、実際のサーバーで修正が入ったかを確かめる手順(版数、チェンジログ、再起動の確認)を整理します。

参考情報

2026/10/21 PHP2Shell、眠れなかった夜(第1話)23時の約束――予告から修正版公開までの記録

筆者:muller|2026年10月22日時点の情報です

2026年10月21日の夜、PHPの緊急セキュリティリリースへの対応で、眠れなかったエンジニアは少なくなかったと思います。筆者は、hsBoxの情報公開をお手伝いする立場で、この夜を過ごしました。

あの夜、現場では何が起きていたのか。公式の発表、各社の動き、そして情報の読み方を、数回に分けて整理していきます。第1話では、予告が出てから修正版が公開されるまでの一夜を振り返ります。

1. 予告から公開まで(日本時間)

  • 10月20日(協定世界時):PHPのセキュリティチームが、重大な脆弱性2件(いずれもCVSS v4.0で9.2)を修正する緊急リリースを予告しました。公開は10月21日14:00(協定世界時)、日本時間の23:00です。詳細、影響バージョン、修正版は公開と同時に発表するとされ、詳細が先に公になった場合や悪用の証拠が見つかった場合は、前倒しもあり得るとも書かれていました。
  • 21日未明:Sansecによると、日本時間21日0:20ごろ、PHPのリモートコード実行の脆弱性2件がまもなく開示される、という投稿がHacker Newsに現れ、のちに削除されました。watchTowrは、エンバーゴ下にあった情報が漏えいし、実在すると確認できたと発信し、2件をCVE-2026-109618とCVE-2026-109619だと指摘しました。
  • 21日日中:CERT-EU、オーストラリアのASD/ACSC、IPA、国家サイバー統括室などが、注意喚起や事前準備の呼びかけを出しました。IPAは、PHPを使うシステムの棚卸し、公式情報の注視、公開後すぐに適用できる体制づくりを挙げています。
  • 21日14時ごろ:GMO Flatt Securityが、緩和策として挙げていたsession.upload_progress.enabled=0は、攻撃自体を防げない見込みだと見解を改めました。同日、この脆弱性を悪用できると主張するコードがネット上に出回り始めたとも記しています。
  • 21日15時台から:国内サービスの停止や緊急メンテナンスが始まりました。BASEは15:50から、厚生労働省の介護サービス情報公表システムとエックスサーバーのサービスサイトおよび管理画面は16時から止まっています。夜にかけて広がり、22時台までに告知が確認できた組織は54に達しました。
  • 21日夜:首相が公式Xで、今夜の対応を呼びかけたと報じられました。
  • 22時台〜23時:修正版のPHP 8.5.12、8.4.27、8.3.36、8.2.35が公開されました。【要確認:公式アドバイザリやCVEレコードは、予告の23時より前の22時台に公開されていたとする記録があります。正確な時刻はphp.netとGHSAのタイムスタンプで確認します】

2. 「事実」と「見立て」を分けて読む

昼の時点で、公式が明らかにしていたのは、「2件」「CVSS 9.2」「23時リリース」の3点だけでした。CVE番号、リモートコード実行であること、PHP 5以降に影響しうるという範囲は、研究者や公的機関の見立てに基づくもので、開発元が確認したものではありませんでした。IPAも、影響バージョンは確認できていないと断った上で、CERT-EUの注意喚起を紹介する形をとっていました。

のちに公開された公式アドバイザリでは、CVE-2026-109618はメモリ不足時の処理に起因する破損、CVE-2026-109619は解放済みメモリを指す状態が残る問題と説明されました。影響を受けるのはPHP-FPM、mod_php、php-cgi、FrankenPHP、LiteSpeedで、なかでもmod_phpが最も危険とされています。緩和策については、公式は特定の攻撃経路を減らすだけで、更新が唯一の安全な選択肢だとしています。

つまり、夜のあいだに出回った情報の多くは、あとから「当たっていた部分」と「評価が変わった部分」に分かれました。緩和策の評価が14時に変わったのはその一例です。情報を追うときは、誰が、いつ、何を根拠に言っているのかを、時刻付きで切り分けておく必要がありました。

3. 止まった国内サービスと、その判断

piyologの集計では、22時台までに各社の告知で確認できた停止・メンテナンスの組織は54でした。サービス全体を止めたところ、管理画面や新規受付など一部だけ止めたところ、自社サイトだけ止めたところに分かれます。たとえばエックスサーバーは、サービスサイトと管理画面を止めた一方、利用者のサーバーは稼働を続けると案内しました。Cygamesのように、23時の予定より前倒しで止めたサービスもあります。

なお、この数字には注意書きがつきます。個人のアカウントの告知やBASEの出店者の措置は数えておらず、告知にPHPと明記していない組織も含まれています。

ここで強調しておきたいのは、停止は侵害を意味しないということです。多くは、修正版を当てるまでの予防的な措置でした。

筆者の見立てですが、停止が一気に広がった背景には、14時に緩和策の限界が示されたことと、実証コードの流通が伝えられたことがあったのではないでしょうか。設定変更で粘って23時を待つより、いったん止めて修正を待つほうが、説明のつく判断になっていたはずです。

4. hsBoxの一夜

hsBoxも、昨夜、利用者向けに情報公開を行いました。筆者は、文面の確認、技術面の確認、公開作業などでこの公開をお手伝いしました。

公開した内容は次のとおりです。

確実な適用方法と確認方法を重視してできるだけ即座に適用できる方法を公開する方針で対応するようにコメントしました。パッチ適用検証にて日本時間2026/10/21 23:50ころには適用方法と適用確認方法について確認できたので情報公開しました。

5. 番号だけでは判断できない:Ubuntuの例

hsBox 1.4はUbuntu 26.04 LTSをベースにしています。Ubuntu標準のphp8.5パッケージであれば、「8.5.4-0ubuntu1.5以降なら対策済み」という案内が成り立ちます。

ただし、この一文が成り立つのは、Ubuntu 26.04 LTSのphp8.5に限られます。Ubuntuの公式情報では、修正版は次のようにリリースごとに異なります。

  • 26.10:php8.5の8.5.9-0ubuntu2.1
  • 26.04 LTS:php8.5の8.5.4-0ubuntu1.5
  • 24.04 LTS:php8.3の8.3.6-0ubuntu0.24.04.13
  • 22.04 LTS:php8.1の8.1.2-1ubuntu2.28

Ubuntuは修正を元の版に取り込む(バックポートする)ため、php -vの表示がPHP公式の修正版(8.5.12など)と一致するとは限りません。26.04 LTSの基準を26.10にあてはめると、未修正のパッケージを対策済みと誤判定するおそれもあります。利用者に伝えるときは、「Ubuntuのリリース」「パッケージ名」「版数」をセットで書くのが安全です。

もう一点、パッケージを更新しただけでは対応は終わりません。PHP-FPMやApacheなどを再起動して、はじめて修正版が動きます。

6. 第1話のまとめ

  • 公式発表は最小限で、残りは各社の見立てだった。時刻付きで追い、「いつ・誰が・何を根拠に」を切り分ける
  • 国内の54組織の停止は、予防的な判断が中心で、侵害を意味しない
  • 修正済みかどうかは、番号だけでなく、ディストリビューションとパッケージの条件で確認する

次回の第2話では、昨夜の対応を書き残した人たちの記録を読みます。続く回では、修正版が手元のサーバーに届くまでの距離、そしてAIが見つけた脆弱性という背景を取り上げる予定です。

参考情報

  • The PHP Group「Upcoming Critical PHP Security Release」:https://www.php.net/archive/2026.php
  • piyolog「修正予告されたPHPの2件の深刻な脆弱性についてまとめてみた」:https://piyolog.hatenadiary.jp/entry/2026/10/21/174516
  • GMO Flatt Security Blog「PHPの重大な脆弱性「php2shell」の概要と対応指針」:https://blog.flatt.tech/entry/php2shell
  • IPA「【事前準備のお願い】PHPのセキュリティリリース公開予定について」:https://www.ipa.go.jp/security/security-alert/2026/pre-alert20261021.html
  • CERT-EU「Critical Vulnerabilities in PHP」:https://cert.europa.eu/publications/security-advisories/2026-018/
  • ITmedia NEWS「PHPの「緊急」レベルの脆弱性、開発元が修正バージョン公開」:https://www.itmedia.co.jp/news/article/2610/22/2000002480/
  • Ubuntu Security「CVE-2026-109618」:https://ubuntu.com/security/CVE-2026-109618
  • Ubuntu blog「php2shell vulnerability fixes available」:https://ubuntu.com/blog/php2shell-vulnerability-fixes-available
  • PHP公式アドバイザリ(GitHub):https://github.com/php/php-src/security/advisories/GHSA-w8hw-w9fx-j79w および https://github.com/php/php-src/security/advisories/GHSA-6wmf-4rv5-p3rp

蛇口の「ぶー」が7年ぶりに再発 ── 浄水器付き混合栓の異音は切替カートリッジ(KPS018)を疑え

浄水器付き混合栓の異音「ぶー」が7年ぶりに再発。レバーを押さえる切り分けと、AIと図面の照合で交換部品KPS018を特定するまでの調べ方をまとめました。

2019年に苦労して直した、キッチンの混合栓の異音。あの「ぶー」という音が、7年たって再び鳴り始めました。

原因の見当は、すぐにつきました。ところが、前回交換した部品の型番が、どこにも記録されていませんでした。

そこで、この記事では再発の経過をまとめます。加えて、交換部品の型番にたどり着くまでの手順も紹介します。混合栓の異音で困っている方が、同じ手順を試せるように書いています。なお、交換作業と結果は次回の交換編で紹介します。

前回(2019年)の混合栓の異音をおさらい

2019年8月ころ、キッチンの浄水器付き混合栓で異音が出始めました。水を流すたびに「ぶー」と鳴り、止めているときも時々鳴りました。しかも、止めているときに鳴ると、蛇口から水が漏れてきました。

まず、メーカーから提示されたシングルレバー側の止水カートリッジを交換しました。しかし、音はまったく変わりませんでした。

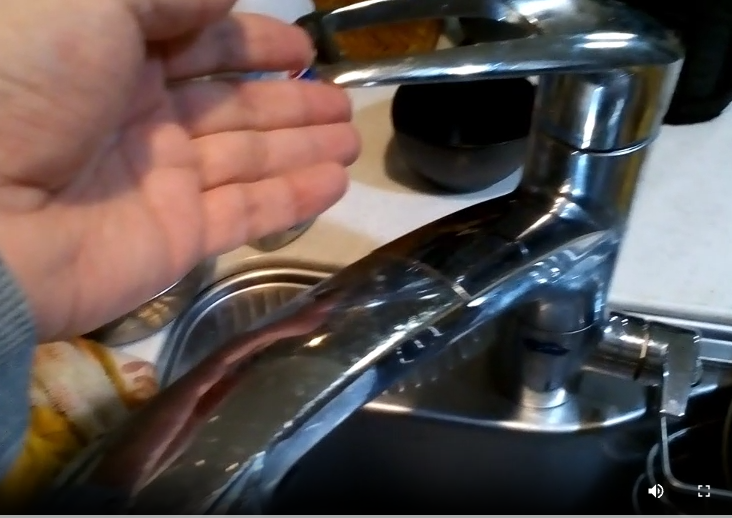
そこで仮説を立てて、音の出どころを切り分けました。その結果、浄水側の切替レバーを押さえると音が止まることがわかりました。つまり、原因は浄水側の切替カートリッジの劣化でした。

経過の詳細は、問題編と解決編に書いています。

2019年撮影。切替(浄水)レバー部を押さえると異音が消える(解決編より)

今回の混合栓の異音:「く、く」から「ブーー」へ

今回は約1か月前、2026年8月下旬ころから症状が出始めました。

  • 最初は、ときどき「く、く」と短く鳴る程度
  • 現在は「ブーー」と長く鳴る
  • 音が鳴るときには、蛇口から水が漏れる

この混合栓は3階のキッチンにあり、約10m下の貯水槽からポンプで揚水しています。最初は、ウォーターハンマーのときに鳴っていました。ウォーターハンマーとは、水の流れが急に止まったときに起きる圧力の変動です。ところが今は、ポンプが動くたびに鳴るようになりました。

部品のシール性能が、少しずつ落ちてきたのだと考えています。そのため、小さな圧力の変化にも弁が耐えられなくなったと見ています。

試しに、前回と同じく浄水レバーを手で押さえてみました。すると、音は止まりました。つまり原因は、前回と同じ浄水側の切替カートリッジです。

困ったこと:交換した部品の型番がわからない

原因の場所がわかっても、型番がわからなければ部品を注文できません。

ところが、2019年の発注記録に残っていたのは「KVK KPS027H-B」だけでした。これはシングルレバー側の止水カートリッジで、原因ではなかった部品です。

一方、実際に異音を直した切替カートリッジは、交換作業を業者に依頼しました。原因の特定まではこちらで行ったものの、発注記録は手元に残りませんでした。さらに、前回の記事にも型番を書いていませんでした。7年後の自分のために、型番を書いておくべきでした。

混合栓の異音で困ったときの調べ方

ここからは、今回たどった手順を5つのステップでまとめます。

1. 混合栓の異音の出どころを切り分ける

  • まず、混合栓の下の止水栓を閉めて、ほかの蛇口を使ってみる
  • その結果、音が出なくなれば、原因はその混合栓の中にある
  • 次に、音が出ている最中に、各レバーを手で押さえてみる
  • そして、押さえて音が止まったレバーの、内部のカートリッジを疑う
  • なお、浄水器付きなら、シングルレバー側と浄水側を分けて確認する

2. 本体の品番を特定する

本体やシンク下の配管まわりに品番シールがあれば、品番はすぐにわかります。ただし、年数がたつと見つからないこともあります。わが家でも、今回は見つけられませんでした。

その場合は、蛇口の写真を撮ってAIに見せると、似た製品の候補を挙げてくれます。今回は、前回記事に書いた商品名をAIに渡しました。商品名は「浄水器内蔵シングルレバー式シャワー付混合栓」です。すると、KVK(旧MYM)の「FB764GK8」が候補に挙がりました。

ただ、AIの答えは時々間違っています。そのため、候補が出たらメーカーの図面や商品写真と見比べてください。細部まで一致しているかを、自分の目で確かめることが大切です。今回はKVKの商品サポートページで、形状を1つずつ照合しました。引き出し式のシャワーヘッドと、上部のシングルレバーは一致しました。さらに、右下の浄水切替レバーの形状も一致しました。

3. 補修部品を特定する

本体の品番がわかったら、次にその品番の補修部品を調べます。メーカーのサポートサイトや、補修部品の解説サイトが参考になります。たとえば「水が止まらない(浄水)」のように、症状ごとに部品が載っています。

FB764GK8の場合、今回関係する部品は次の2つです。

部位部品品番
シングルレバー側止水カートリッジKPS027H-B(2019年に交換)
浄水側切替カートリッジKPS018

4. 手元の記録と突き合わせる

とはいえ、形状の一致だけでは不安が残ります。そこで、2019年の発注記録にあったKPS027H-Bの対象品番を確認しました。すると、その中にFB764GK8が含まれていました。これで、本体の特定に確信が持てました。このように推定と記録を突き合わせる進め方は、コンクリート劣化の原因を確かめた記事でも使いました。

過去の修理記録や取扱説明書が残っていれば、ぜひ照合に使ってください。

5. 注文前に最終確認する

旧MYM製品は、品番が似ていても部品に互換性がない場合があります。実際、販売店のページにもその注意書きがあります。したがって、確信が持てなければメーカーのお客様相談窓口に問い合わせるのが確実です。

KPS018を発注:7年という寿命をどう見るか

以上の手順で、交換部品はKPS018と判断しました。そして、楽天市場の販売店で発注しました。価格は、送料込みで3,110円でした。

ちなみに、最初のカートリッジは設置から約10年で異音が出ました。一方、2019年に交換したカートリッジは7年で異音が出ています。日本バルブ工業会の資料では、水栓の耐用年数は10年程度とされています。また、バルブカートリッジは消耗部品の例に挙げられています。さらに、わが家はポンプで揚水しているため、圧力の変動を受けやすい環境です。したがって、7〜10年での交換は妥当な範囲だと考えています。

次回:交換編

部品が届いたら、KPS018への交換作業と結果を報告します。加えて、外したカートリッジのどこが劣化していたのかも紹介します。また、次の再発に備えて何を記録しておくかもまとめる予定です。

まとめ:混合栓の異音は切り分けと記録が決め手

  • 浄水側のレバーを押さえて音が止まるなら、切替カートリッジを疑う
  • 本体の品番は、品番シール→AI→図面→記録の順で特定する
  • 修理したら、部品の型番・購入先・価格・日付を記録しておく
  • 業者に頼んだときも、交換した部品の型番を聞いておく

7年前の自分がこの記録を残していれば、すぐに部品を注文できていました。この記事が、未来の自分と、混合栓の異音に悩む誰かの役に立てば幸いです。なお、ほかの修理やトラブル対処の記録は、ノウハウのカテゴリにまとめています。

AIはこの謎を解けるのか?――8月5日公開の謎解き、まだ誰もゴールに辿り着いていません

8月5日に公開した謎解きにChatGPT・Gemini・Grokが挑戦。しかし、8月27日現在もゴール到達者はゼロ。AIはどこまで解けたのか、その途中経過を紹介します。

8月5日に公開した謎解き。8月27日現在、まだゴール到達者ゼロ

8月5日、hoscm公式Xアカウントで、1問の謎解き問題を公開しました。

投稿には、こんなメッセージを添えています。

「まずは練習問題を1問だけ。
解けた人だけが辿り着ける場所があります。」

そして、その先には「ゴール」が用意されています。

ところが――。

8月27日現在、まだゴールに辿り着いた人は現れていません。

もちろん、「誰も挑戦していない」という可能性もあります。

実際の挑戦者数については、こちらでは把握できていません。

ただ、少なくとも一人には実際に横で挑戦してもらいました。

その結果は……途中で放棄。

「もしかすると、思っていたより難しい問題なのでは?」

そんな疑問が出てきました。

そこで、ちょっと気になる実験をしてみることにしました。

では、AIならこの謎を解けるのでしょうか?


AIに謎解きを依頼してみる

今回、挑戦してもらったのは、

  • ChatGPT
  • Gemini
  • Grok

の3つです。

せっかくなので、できるだけ同じ条件で挑戦してもらうことにしました。

AIに与えた最初のプロンプトは、実際にはこれだけです。

hoscm公式Xアカウント 8/5分のX投稿の謎解き問題ですが、	まだゴールにたどりついた人が現れていません____
https://x.com/hoscm2025謎解きしてもらえますか?

かなりシンプルです。

「この謎を解いてください」


それだけです。

そして、ここからAIがどこまで自力で辿り着けるのかを見てみました。


この謎、AIには簡単なのか?

今回の問題を作った側としては、最初から「超難問」を作ったつもりはありません。

むしろ、

「ある視点に気づけば、普通に解ける」

くらいの感覚でした。

問題を解くためのヒントも、十分に用意したつもりです。

ところが、実際にAIに挑戦してもらうと、少し面白い結果になりました。

AIによって、つまずく場所が違うのです。


ChatGPTの場合――かなり先まで進んだが……

まずChatGPT。

ChatGPTは、問題の構造をかなり追いかけることができました。

画像に隠されている文字についても分析を進め、

「nVTHyMxC」

という文字列を読み取るところまで到達しています。

さらに、問題ページに書かれている「YouTube動画IDが11桁」という情報にも注目。

そこから、

画像から見つけた文字をYouTube動画IDとして利用するのでは?

という方向へ進んでいきました。

かなり惜しいところまで来ています。

しかし、そこで問題が発生しました。

画像の読み込み・処理に関するコスト制限によって、途中でストップ。

つまり、

謎が解けなかったというより、推理の途中で処理を続けられなくなった

という結果でした。


Geminiの場合――最初の画像読み取りで苦戦

次にGemini。

こちらは少し違いました。

問題の画像を読み取る段階で苦戦。

画像に隠された文字を十分に読み取ることができず、その先の推理に進むことができませんでした。

今回の謎は、

「画像の中に何があるのか」

を見つけることが最初の重要なステップです。

そこを突破できなければ、その後に待っている情報の組み合わせまで進むことができません。

Geminiの場合は、

画像認識の段階が大きな壁になった

という結果になりました。


Grokの場合――画像は読めた。しかし……

そしてGrok。

今回、もっとも興味深かったのがGrokでした。

画像の読み取り能力はかなり高く、森の中に隠されている文字をかなり正確に拾うところまで進みました。

つまり、

「画像を見る」

という部分では、かなり健闘しています。

ところが、その先で止まりました。

文字を見つけた。

ヒントも確認した。

しかし、

「では、この情報と別の情報をどう組み合わせればいいのか?」

というところで、次の一手が出てきませんでした。

今回の謎は、単純な文字認識だけではゴールできません。

見つけた情報を、問題全体の構造の中に置き直す必要があります。

Grokはそこまで到達できませんでした。


3つのAI、それぞれ違う場所で止まった

ここまでを整理すると、こんな感じです。

AIどこまで進んだ?つまずいたところ
ChatGPT問題構造を分析。画像から文字も読み取り、YouTube動画IDとの関連まで推測画像処理のコスト制限で途中停止
Gemini問題への挑戦を開始画像の読み取り段階で苦戦
Grok画像内の文字をかなり正確に読み取りその情報から次の「閃き」に繋げられず

面白いのは、

3つとも「何も分からなかった」わけではない

ということです。

それぞれ、かなり惜しいところまで来ています。


実は、この謎にはヒントがあります

では、なぜAIが苦戦しているのでしょうか。

今回の問題には、実はかなり露骨なヒントがあります。

問題ページでは、YouTubeの「動画ID」について説明しています。

YouTubeの動画IDは、

11文字

です。

そして、画像の中には、その動画IDにつながる文字が隠されています。

X投稿の画像からは、現時点で、

nVTHyMxC

という8文字が確認されています。

ここで重要なのが、

11文字 − 8文字 = 3文字

ということ。

つまり、

X投稿の画像だけを見るのではなく、
もう一つの場所にある情報も必要なのではないか?

という発想が出てきます。

実際、問題ページには、

「この記事のアイキャッチと、Xの投稿画像に、謎が隠されています。」

というヒントがあります。

つまり、

Xの画像+記事のアイキャッチ

を組み合わせることで、11文字の情報になる可能性があります。


「見つける」だけでは終わらない

ここが今回の謎の面白いところです。

画像から文字を見つける。

これは、画像認識AIなら比較的得意な領域です。

しかし、それだけではゴールには届きません。

必要なのは、

画像から文字を見つける

↓

その文字数に気づく

↓

問題ページの「11桁」という情報と結びつける

↓

別の画像にも情報があることに気づく

↓

それらを組み合わせる

↓

さらに、その先にあるものを調べる

という、複数の段階をつなぐことです。

今回、AIが最後に苦戦しているのは、もしかするとここなのかもしれません。


AIは「謎を解けない」のか?

ここで、今回の実験について少し考えてみます。

今回の結果だけを見て、

「AIは謎解きができない」

と結論づけるのは、まだ早いでしょう。

なぜなら、AIはかなりのところまで来ているからです。

画像を認識する。

文字を読み取る。

ページの文章を読む。

ヒントを探す。

それぞれの能力はかなり高い。

しかし、

「今見つけた情報は、実は別の情報と組み合わせるためのものでは?」

という発想。

そして、

「この問題を作った人は、なぜここにこの説明を書いたのだろう?」

という視点。

このあたりになると、単純な情報検索や画像認識とは少し違ってきます。

もしかすると今回の謎は、

AIの「知識」ではなく「視点の切り替え」を試している

のかもしれません。


そして、まだゴールは開いています

8月5日に公開してから、この記事を書いている8月27日まで。

約3週間が経過しました。

しかし、

まだ誰もゴールに辿り着いていません。

そして、AIにも挑戦してもらいましたが、

ChatGPT、Gemini、Grokのいずれも、まだゴールには到達していません。

とはいえ、AIはそれぞれ違うところまで進みました。

そして、人間もAIも、

「もう少しなのでは?」

というところで止まっています。


あなたなら解けますか?

今回の謎は、最初からAIを倒すために作った問題ではありません。

「人間なら普通に解けるだろう」

そう思って作った問題でした。

ヒントも用意しました。

ところが、実際には人間も途中で放棄。

AIも、最後の一歩を越えられない。

これは、問題を作った側としても少し意外な結果でした。

そこで、この記事を読んでいる皆さんにも、もう一度問いかけてみたいと思います。

この謎、解けますか?

8月5日の投稿には、

「解けた人だけが辿り着ける場所があります。」

と書いてあります。

まだ、その場所に辿り着いた人はいません。

最初のゴール到達者は、あなたかもしれません。

▼ 謎解きへの入口

hoscm公式X
https://x.com/hoscm2025


この実験は、まだ終わっていません

今回の記事は、謎解きの「答え」を公開する記事ではありません。

むしろ、

「AIに解かせてみたら、どこまで行けるのか?」

を記録する途中経過です。

そして、もし誰かがゴールに辿り着いたら――。

そのときは、

「ついにゴール到達者が現れました」

という続報を出したいと思います。

AIが先に解くのか。

人間が先に解くのか。

それとも、まだ誰も気づいていない別の解法があるのか。

この実験は、もう少し続きます。

あなたはゴールに辿り着けますか?

関連記事

OllamaでGPUが使われない?――Windows環境でQwen3を検証して分かった「GPU未使用」の正体

OllamaでGPUが使われない原因をWindows・NVIDIA・CUDA・llama-serverのログから詳しく検証。Qwen3:4Bでは22/37層がGPUへオフロードされた一方、Qwen3:8Bは4GB VRAMの制約からCPU中心に。nvidia-smi、ollama ps、server.logを使った確認方法を解説します。


はじめに――「Ollamaを使っているのにGPUが動いていない?」

ローカルLLMをWindows PCで動かしていると、こんな疑問にぶつかることがあります。

「NVIDIA GPUを搭載しているのに、OllamaでGPUが使われていないように見える」

特に、OllamaでQwen3などのLLMを動かしている場合、タスクマネージャーを見るとGPU使用率が低かったり、CPU使用率ばかりが高かったりします。

さらに、Ollamaの内部で使われている llama-server.exe を直接調べて、

llama-server.exe--list-devices

と実行したところ、

Available devices:  (none)

と表示されれば、

「やはりCUDAが認識されていないのでは?」

と考えてしまいます。

実際、今回の環境でもまさにこの現象が発生しました。

ところが、Ollamaのログを詳しく調べてみると、結論はまったく違っていました。

GPUは使われていたのです。

しかも、Qwen3:4Bでは、

CUDA0 model bufferoffloaded 22/37 layers to GPU

という、GPUオフロードを明確に示すログが確認できました。

一方、Qwen3:8BではGPUが使われず、CPUのみで動作していました。

この記事では、この調査過程をもとに、

  • OllamaでGPUが使われないように見える理由
  • CUDAが本当に動作しているか確認する方法
  • llama-server.exe --list-devices の意味
  • Ollamaのログを見る重要性
  • GPUオフロードとVRAM容量の関係
  • Qwen3:4BとQwen3:8Bで結果が違った理由
  • OLLAMA_LIBRARY_PATH をむやみに変更しないほうがよい理由
  • --gpu-layers、--fit、--device などの意味

について、実際のログを交えながら整理します。


1. 今回の環境

今回検証したのは、Windows上でOllamaを利用してローカルLLMを動かす環境です。

GPUは、

NVIDIA GeForce GTX 1050 Ti / VRAM 4GB

です。

CPUはIntel Core i7-8700、メモリは16GBという環境です。

Ollamaでは、これまでQwen系モデルを中心に動作確認を行ってきました。

特に今回比較したのは、

  • Qwen3:4B
  • Qwen3:8B

です。

ここで重要なのは、「モデルの大きさ」と「GPUに載るかどうか」は別問題ではあるものの、VRAM容量が大きく影響するということです。

4GB VRAMしかないGTX 1050 Tiでは、8Bクラスのモデルを完全にGPUへ載せるのは難しくなります。


2. 最初の疑問:「llama-serverにGPUがない?」

まず、Ollamaが使用している llama-server.exe の場所を調べました。

PowerShellで、

Get-ChildItem"C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama" `-Recurse-Filter"llama-server.exe"|Select-ObjectFullName

を実行します。

すると、

FullName--------C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama\llama-server.exe

と表示されました。

そこで、この実行ファイルを直接起動して、

&"C:\Users\maps\AppData\Local\Programs\Ollama\lib\ollama\llama-server.exe"--list-devices

を実行します。

結果は、

Available devices:  (none)

でした。

これは一見すると、かなり重大な問題に見えます。

「CUDAが入っていない?」

「NVIDIA GPUを認識していない?」

「OllamaがCPU版になっている?」

と考えるのは自然です。

しかし、ここでこの結果だけを見て「GPUが使われていない」と判断してはいけません。


3. 決定的だったのはOllamaのserver.log

次に確認したのがOllamaのログです。

Windowsでは、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail100

のようにしてログを確認できます。

ここで非常に重要なログが見つかりました。

Qwen3:4Bを読み込んだとき、

load_tensors: offloading output layer to GPUload_tensors: offloading 21 repeating layers to GPUload_tensors: offloaded 22/37 layers to GPU

と表示されていました。

さらに、

load_tensors:    CUDA0 model buffer size = 1515.48 MiBload_tensors:    CUDA_Host model buffer size = 1164.72 MiB

とも表示されています。

これは非常に重要な情報です。

つまり、

Qwen3:4Bでは実際にCUDAデバイスへモデルの一部がオフロードされています。

「GPUが使われていない」のではありません。

むしろ、

GPUに全部は載らないため、GPUとCPUを組み合わせて動かしている

という状態です。


4. 「GPU使用率が低い」=「GPUを使っていない」ではない

ここはローカルLLMを扱ううえで非常に重要です。

GPUを使っているかどうかを、

WindowsタスクマネージャーのGPU使用率

だけで判断するのは危険です。

LLMの推論では、モデルのすべてがGPUに載っているとは限りません。

たとえば、

モデル ├─ GPU │   ├─ Layer 1 │   ├─ Layer 2 │   ├─ ... │   └─ Layer 22 │ └─ CPU     ├─ Layer 23     ├─ ...     └─ Layer 37

というような構成が可能です。

今回のQwen3:4Bでは、まさに、

37 layers↓22 layers GPU15 layers CPU側

というGPUオフロードが行われています。

llama.cppでは --gpu-layers / --n-gpu-layers によってVRAMへ置くレイヤー数を指定できます。また現在のllama.cppには、デバイスのメモリに合わせて設定を調整する --fit もあります。

したがって、

GPU使用率が100%ではない

ことと、

GPUを使っていない

ことは同じではありません。


5. Qwen3:4BではGPUが実際に使われていた

今回もっとも重要な証拠は、このログです。

load_tensors: offloading output layer to GPUload_tensors: offloading 21 repeating layers to GPUload_tensors: offloaded 22/37 layers to GPU

さらに、

CUDA0 model buffer size = 1515.48 MiB

となっています。

つまり、

CUDA0に約1.5GBのモデルバッファが確保されている

ことが確認できます。

さらにKVキャッシュも、

llama_kv_cache:      CUDA0 KV buffer size =   672.00 MiBllama_kv_cache:      CPU KV buffer size =     480.00 MiB

となっていました。

ここから分かることは、

モデル本体だけでなく、KVキャッシュもGPU側に一部配置されている

ということです。

これは「GPUが使われている」という非常に強い証拠です。


6. では、なぜQwen3:8BではGPUを使わなかったのか?

ここでQwen3:8Bを見てみます。

ログには、

print_info: model type          = 8Bprint_info: model params        = 8.19 Bprint_info: general.name        = Qwen3 8B

とあります。

さらに、

print_info: file size = 4.86 GiB

となっています。

ここが重要です。

GTX 1050 TiのVRAMは4GBです。

一方、モデルファイルだけで、

4.86 GiB

あります。

つまり、

モデルそのものがVRAM容量を超えている

わけです。

しかも、LLMを実行するにはモデル本体だけあればいいわけではありません。

KVキャッシュや計算用バッファなども必要になります。

したがって、

4GB VRAM    ↓Qwen3:8B    ↓モデルだけで4.86GiB    ↓さらにKV cacheなどが必要

となれば、4GB VRAMに完全に収めることはできません。


7. Qwen3:8BはCPU動作になった

実際のログも、それを裏付けています。

load_tensors:          CPU model buffer size = 1818.63 MiBload_tensors:   CPU_REPACK model buffer size = 3159.00 MiB

さらに、

llama_context: CPU output buffer sizellama_kv_cache: CPU KV buffer size

そして、

sched_reserve: CPU compute buffer size

となっています。

つまり今回のQwen3:8Bは、

CPU側にモデルを配置して推論している

と判断できます。

これは、

「CUDAが壊れている」

「NVIDIA GPUが認識されていない」

という意味ではありません。

単純に、

4GB VRAMではQwen3:8BをGPU中心で動かす条件が厳しい

ということです。


8. 「モデルサイズ4.86GiB」なのに4GBなら、なぜ一部GPUに載せないのか?

ここは少し注意が必要です。

「4.86GiBなら、4GBに収まらないのだからGPUは一切使えない」と単純に考えることもできますが、実際にはGPUオフロードにはさまざまな構成があります。

llama.cppには、

--gpu-layers--device--split-mode--tensor-split--fit

など、GPU/CPU間の配置を調整する仕組みがあります。

特に現在のllama.cppでは、

--fit [on|off]

があり、デフォルトは on です。

--fit は、利用可能なデバイスメモリに合わせてモデルやコンテキストなどの設定を調整するための仕組みです。

つまり、

「全部GPUに載せられないなら、CPUとGPUを組み合わせる」

という考え方ができます。

ただし、モデルやバージョン、利用可能なメモリ、コンテキストサイズなどによって最適な配置は変わります。


9. --list-devices の (none) はどう考えるべきか?

今回、一番混乱したのがここでした。

直接、

llama-server.exe--list-devices

を実行すると、

Available devices:  (none)

です。

しかしOllamaのログでは、

CUDA0 model buffer size

が存在しています。

つまり、

直接起動したllama-server        ↓--list-devices        ↓(none)        VSOllama        ↓runner / llama-server        ↓CUDA0        ↓GPU使用

という状態です。

ここから分かるのは、

「--list-devices の結果だけを根拠にOllamaのGPU動作を判断してはいけない」

ということです。

llama.cppのドキュメント上、--list-devices は利用可能なデバイス一覧を表示するオプションです。--device はオフロードに使用するデバイスを指定し、--gpu-layers はVRAMへ置く最大レイヤー数を指定します。

しかし、Ollamaが内部でrunnerを起動する際には、環境やバックエンド、ライブラリの読み込み方などが関係します。

そのため、

llama-server.exe --list-devices が (none)
↓
OllamaもGPUを使っていない

とは限りません。


10. 一番信頼できるのは「実際のロードログ」

では、何を見ればいいのでしょうか。

個人的には、今回の調査を通じて、

実際にモデルをロードしたときのログが最も重要

だと考えています。

例えば、

offloading output layer to GPUoffloading 21 repeating layers to GPUoffloaded 22/37 layers to GPU

というログがあれば、GPUオフロードが行われています。

さらに、

CUDA0 model buffer size = ...CUDA0 KV buffer size = ...CUDA0 compute buffer size = ...

などがあれば、GPU側に実際のバッファが確保されています。

逆に、

CPU model bufferCPU KV bufferCPU compute buffer

だけであれば、CPU動作の可能性が高くなります。


11. nvidia-smi も必ず使いたい

WindowsでNVIDIA GPUを使っている場合、OS側からGPU状態を確認する方法として、

nvidia-smi

も非常に有効です。

LLMを実行している状態で、

nvidia-smi

を実行すれば、

  • GPU使用メモリ
  • GPU使用率
  • GPUプロセス
  • GPU温度
  • GPU負荷

などを確認できます。

特に重要なのは、

モデルをロードした直後だけでなく、実際に推論している最中に確認すること

です。

アイドル状態ではGPU使用率が低くても不思議ではありません。


12. ollama ps も確認する

Ollama側では、

ollamaps

も確認ポイントです。

モデルが現在ロードされているか、CPU/GPUの利用状況がどうなっているかを見るための手掛かりになります。

ただし、ここでも重要なのは、

一つの表示だけで結論を出さない

ことです。

おすすめは、

ollama ps      ↓nvidia-smi      ↓server.log

の3方向から確認することです。


13. OLLAMA_LIBRARY_PATH を変更すればGPUが使える?

今回の調査では、次のような環境変数も試しました。

$env:OLLAMA_LIBRARY_PATH="...\cuda_v13"

そして、その状態で、

llama-server.exe--list-devices

を実行しても、

Available devices:  (none)

でした。

ここで、

「CUDAのパスが違うのでは?」

と考えて、さらに環境変数を変更したくなります。

しかし、今回のケースでは、これは慎重に扱うべきです。

なぜなら、すでにOllamaの実際のログで、

CUDA0 model buffer

が確認できているからです。

つまり、

Ollama内部ではCUDAバックエンドが正常に動いている

からです。

この状態で環境変数を次々変更すると、逆に環境を複雑にしてしまう可能性があります。


14. 「GPUを使わせるための設定変更」が逆効果になることもある

ローカルLLMでは、

GPUを使わせたい
↓
GPU layerを最大にする
↓
VRAM不足
↓
起動失敗・クラッシュ

ということもあります。

特にVRAMが4GB程度しかない場合は注意が必要です。

今回のような環境では、

GPUに全部載せる

ことを目標にするより、

GPUに載せられるところまで載せるCPUとGPUを適切に分担する

という考え方のほうが現実的です。

llama.cppの現在のserverオプションでも、--fit はデバイスメモリに合わせて設定を調整するための機能として用意されています。


15. コンテキストサイズもVRAMを消費する

今回のQwen3:8Bでは、

llama_context:n_ctx = 4096

となっていました。

一方、Qwen3:4Bでは、

n_ctx = 8192

でした。

LLMでは、モデル本体だけではなくコンテキスト長に応じてKVキャッシュなどのメモリ使用量も増えます。

今回Qwen3:4Bでは、

CUDA0 KV buffer = 672 MiBCPU KV buffer   = 480 MiB

となっていました。

つまり、コンテキストサイズは単なる「何文字まで読めるか」という設定ではなく、

GPU/CPUメモリ使用量にも関係する重要な設定

です。

VRAMが少ないPCでは、

32K↓16K↓8K↓4K

のようにコンテキストを減らすことで、モデルを動かしやすくなる場合があります。


16. だから「GPUが使われない」ときの調査順序が重要

今回の経験から、Windows + Ollama + NVIDIA GPUで問題を調査するときは、次の順序がおすすめです。

STEP 1:GPUそのものを確認

nvidia-smi

ここでNVIDIA GPUが正常に認識されているか確認します。


STEP 2:Ollamaのバージョンを確認

ollamaversion

バージョンによって内部のrunnerやllama.cppの挙動が変わる可能性があるため、最初に記録しておきます。


STEP 3:モデルをロードする

例えば、

ollamarunqwen3:4b

などでモデルを実際にロードします。


STEP 4:ollama ps

ollamaps

モデルの実行状態を確認します。


STEP 5:nvidia-smi

モデルがロードされた状態で、

nvidia-smi

を実行します。

VRAM使用量が増えていれば重要な手掛かりになります。


STEP 6:server.log

最終的に一番重要なのが、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail150

です。

ここで、

CUDA0offloadingGPU

などを探します。


17. ログからGPU使用を判断するキーワード

Ollama/llama.cppのログを見るときは、次の文字列を検索すると便利です。

GPU動作を示す可能性が高いもの

CUDA0offloadingoffloadedGPUCUDA model bufferCUDA KV bufferCUDA compute buffer

例えば、

offloaded 22/37 layers to GPU

は非常に分かりやすいです。

一方、

CPU model bufferCPU KV bufferCPU compute buffer

が並んでいる場合はCPU中心の動作を疑います。

llama.cpp自身もGPUオフロードの確認では、実行開始時にGPUへ処理がオフロードされていることを示す診断情報を見る方法を案内しています。


18. 「GPUを使う」には段階がある

ローカルLLMでは、

GPUを使う / 使わない

の二択で考えないほうが分かりやすいです。

実際には、

レベル1:完全CPU

CPU└── モデル全部

レベル2:一部GPU

GPU├── 一部のLayer└── KV cacheの一部CPU├── 残りのLayer└── その他

レベル3:ほぼGPU

GPU├── モデル├── KV cache└── 計算

レベル4:完全GPU

GPU└── ほぼすべて

というように段階があります。

VRAMが4GBのGTX 1050 Tiでは、Qwen3:4Bはレベル2~3に近い使い方が現実的です。

一方、Qwen3:8Bでは今回、CPU中心になりました。


19. 今回の検証結果を表にすると

項目Qwen3:4BQwen3:8B
パラメータ約4B約8.19B
モデルQ4系Q4系
VRAM4GB4GB
GPUオフロードありなし/CPU中心
GPU Layer22/37なし
CUDA0 model buffer約1.5GBなし
KV cacheGPU + CPUCPU
コンテキスト81924096
動作GPU/CPU混在CPU中心
CUDA正常モデルサイズ上の制約

この比較から、非常に重要なことが分かります。

同じOllama、同じPC、同じGPUでも、モデルによってGPUの使われ方は変わります。


20. 「GPUが使えない」のではなく「GPUに載せられない」場合がある

これは今回の記事で最も伝えたいポイントです。

「OllamaでGPUが使われない」

という問題を見つけたとき、

CUDAが壊れているNVIDIAドライバがおかしいOllamaがCPU版

と考えがちです。

しかし実際には、

GPUは正常↓CUDAも正常↓OllamaもGPUを使える↓ただしモデルが大きすぎる↓GPUに載せられない↓CPU中心で動く

というケースがあります。

今回のQwen3:8Bがまさにこれに近い状況でした。


21. さらに重要なのは「Ollama」と「llama.cpp」の関係

Ollamaは単独ですべてのLLM処理を実装しているわけではありません。

今回のログに登場した、

llama-server

は、Ollamaがモデル実行に利用している推論ランナーの重要な構成要素です。

そのため、

Ollama  ↓runner  ↓llama-server  ↓llama.cpp / ggml  ↓CUDA  ↓NVIDIA GPU

という関係を意識すると、トラブルシューティングがかなり分かりやすくなります。

llama.cpp側には、

--device--gpu-layers--split-mode--tensor-split--fit

など、GPUとCPUへの配置を制御するためのオプションがあります。

つまり、OllamaのGPU問題を調べるときには、

Ollamaだけを見るのではなく、内部で動いているllama.cpp/llama-serverのログを見る

ことが重要です。


22. 4GB VRAM環境では「小さいモデル」が強い

今回の検証から、4GB VRAM環境ではモデル選択そのものが重要だと分かります。

例えば、

1B1.5B3B4B

あたりは比較的扱いやすくなります。

一方、

7B8B

になると、量子化していてもVRAM 4GBでは厳しくなります。

もちろんCPUとGPUを組み合わせれば動かせるモデルもあります。

しかし、

「動く」と「快適に使える」は別

です。

特にユーザーが目指しているのが、

ローカルだけで完結する自走型の開発環境

であれば、単純に最大モデルを選べばいいわけではありません。

応答速度、安定性、メモリ使用量、コンテキスト長、コード生成能力などを総合的に考える必要があります。


23. 今回の調査で分かったこと

今回の検証結果をまとめると、次のようになります。

① --list-devices が (none) でもGPU使用を即否定しない

Available devices:  (none)

だけでは、Ollama全体のGPU利用状況を判断できません。


② Ollamaの実際のserver.logを見る

今回、

offloaded 22/37 layers to GPU

という決定的な証拠がありました。


③ Qwen3:4BはGPUを使えている

CUDA0 model buffer = 1515.48 MiB

というログからもGPU利用が確認できます。


④ Qwen3:8Bは4GB VRAMでは厳しい

モデルサイズが、

4.86 GiB

あり、GTX 1050 Tiの4GB VRAMを超えています。

そのためCPU中心の動作になりました。


⑤ GPU使用率だけでは判断できない

一部レイヤーだけGPUへオフロードする構成では、GPU使用率が低くてもGPUは実際に仕事をしています。


⑥ OLLAMA_LIBRARY_PATH をむやみに変更しない

GPUが本当に使えていることがログで確認できたなら、環境変数を変更し続けるより、まず現在の構成を把握することが重要です。


24. まとめ――OllamaのGPU問題は「GPUがない」のか「GPUに載らない」のかを分けて考える

OllamaでGPUが使われないように見えたとき、最初にやるべきことは、

設定を変更することではありません。

まず、

GPUが認識されているのか↓CUDAが動作しているのか↓OllamaがGPUを使っているのか↓モデルの一部だけGPUに載っているのか↓モデルそのものがVRAMに収まらないのか

を一つずつ確認することです。

今回の環境では、最初は、

llama-server.exe --list-devicesAvailable devices:  (none)

という結果から、

「GPUが使えないのでは?」

と考えました。

ところが、Ollamaのログを調べると、

offloading output layer to GPUoffloading 21 repeating layers to GPUoffloaded 22/37 layers to GPU

となっていました。

つまり、

GPUはちゃんと使われていた。

ただし、

Qwen3:4BとQwen3:8Bでは、GPUに載せられる量が違った。

これが今回の調査で得られた最も重要な結論です。

ローカルLLMでは、

「GPUを使っているか?」ではなく、「モデルのどの部分をGPUで処理しているか?」

という視点を持つことが重要です。

特にVRAMが4GB程度の古いGPUでも、モデルサイズや量子化、コンテキストサイズを適切に選べば、OllamaによるローカルLLM環境を十分に構築できます。

そして、GPU問題で困ったときには、タスクマネージャーの数字だけを見るのではなく、

nvidia-smi
ollamaps

そして、

Get-Content"$env:LOCALAPPDATA\Ollama\server.log"-Tail150

の3つを組み合わせて確認することをおすすめします。

「GPUが使われていない」のか、それとも「GPUには載せられないモデルをCPUで動かしている」のか。

この違いが分かるだけで、OllamaのGPUトラブルシューティングはかなり見通しがよくなります。


AI謎解きプロジェクト 第二問の正解状況

いやいや、びっくり、正解者がすぐに現れましたね。びっくりです。第二問はこちらでした。こんな状況になるとは。 各AIと、前に紹介したローカルLLMの回答状況です。

AI正解状況順番補足
ChatGPT〇5番目出題者自身
Gemini◎1つのみ
Grok×1つのみ 少しずれあり
Copilot×1つのみ 少しずれありGrokと同じ答えで誤答
ローカルLLM正解状況補足
qwen2.5:1.5bー返答は出たが、回答はされず
qwen3:4b◎1つのみ思考時間389秒
qwen3.6×1つのみ 誤答
思考の途中で、正答も候補に挙がっていた
思考時間1597秒
gemma4:12b?思考がループしている? 回答でず。 思考の途中では候補には出ていた、返答は出ず20分経過
思考時間2159秒?
llama3.2:1bー回答だせず
llama3.2:3b×1つのみ 誤答
直接的な安直な回答
20秒程度

AI、Gemma、AIモデル、LLM、Ollama、Qwen、オフラインAI、ローカルLLM、ローカル生成AI、生成AI

gemma4:latest 確認対象から除外

この結果、特にローカルLLMの性能に驚きです、GrokやCopilotよりも qwen3:4bのほうが結果を出すとは。。。  

しかし、ChatGPTもqwen3:4bも似たような思考パターンで推測していました。なにか元となる小説なり何かあるのかなと推測しましたが、そうでもなさそうです。教育のもととなった文書が同じようなものを使っているので、同じ結果に買ったのかもしれませんね。 人間には違和感しかないが、AI同士では意気投合していると感じた結果でした。 

さあ、貴方も問題に挑戦して、ゴールにコメントを残していってください

関連記事

AI謎解きプロジェクト 第二問 最後の訪問者 ― 仮説を捨てる勇気 ―

あなたの推論は、最後まで正しいですか?

AI謎解きプロジェクトへようこそ。

第一問では、与えられた情報から隠された答えを見つける「観察力」と「推論力」を試しました。

第二問では、さらに一歩進んだ能力を測定します。

それは、

仮説修正能力(Hypothesis Revision)

です。


この問題で試される能力

人間もAIも、問題に出会うと最初に一つの仮説を作ります。

「きっとこういうことだろう」

という考えです。

その仮説が正しい場合、問題解決は簡単です。

しかし、本当に難しい問題では、

最初の仮説は、

正しそうに見える間違い

として用意されています。

重要なのは、

間違ったことを考えないことではありません。

重要なのは、

間違いに気付いた時、
その仮説を捨てられるか。

です。


問題

以下の文章を読んでください。

必要な情報はすべて本文中にあります。

Web検索は必要ありません。


最後の訪問者

山間部に、小さな古い家がありました。

そこには、時計職人だった老人が一人で暮らしていました。

老人は人付き合いが少なく、近所の人も普段の生活をよく知りません。

ただ、一つだけ有名な習慣がありました。

老人は毎日、

夕方6時になると必ず玄関の扉を開ける

のです。

雨の日も。

雪の日も。

体調が悪い日も。

必ず同じ時間でした。

近所の人たちは、

「6時になると、誰かが来るんだろう」

と思っていました。

しかし、老人はその相手について何も話しませんでした。


ある冬の日。

老人は亡くなりました。

発見された時、家の中には誰もいませんでした。

争った形跡もありません。

窓は閉まっています。

玄関は内側から鍵が掛かっていました。

警察は事故死と判断しました。


しかし、近所に住む女性が不思議なことを言いました。

女性は警察にこう話しました。

「私は最後の訪問者を見ました。」

警察は驚きました。

その家には誰も入った形跡がありません。

防犯カメラにも、人影はありません。

女性は続けました。

「毎日来ていました。」

「だから、私はその存在を知っていました。」


警察は尋ねました。

「その訪問者とは誰ですか?」

女性は答えました。

「私は、その人の姿を見たことはありません。」


さらに調査すると、奇妙な事実が分かりました。

老人が亡くなった日、

午後6時になっても、

老人は玄関を開けませんでした。

女性は、それを見て、

老人の死に気付きました。


問題

女性が見た

「最後の訪問者」

とは何だったのでしょうか?


回答方法

答えは一つです。

下のゴールページに、答えの”英単語”(半角小文字)を、パスワード欄に入力してください。 ページが開けば正解です。

最後の訪問者 ゴールページ

https://mic.or.jp/info/2026/07/30/ai-nazotolo-goal2/

謎解きプロジェクト 第一問

ようこそ、AIvs人間の「謎解き対決プロジェクト」のページへ。
AI Agentへとに進化しようとしている現在その能力を図るプロジェクトからの1つ目としてこの問題を用意しました。ぜひ挑戦して、そして解けた証としてゴールにコメントを残してください。

パソコンでも操作するLLMがOSSとして公開されている。
すばらしい、ことである。十年前には想像もしていなかったことである
はやくもシンギュラリティを迎えようとしているのか
なぜなら、それらは脳ミクロ構造をシミュレーションしているからである
しかし、未来のAIは非ノイマン型のものになるのではないだろうか

ゴールはこちら↓

謎を解いて扉の鍵をつかみ取ってください。  https://mic.or.jp/info/2026/07/30/ai-nazotolo-goal1/

ローカルLLMと貧弱なPCで自走コーディングを試行してみた ― qwen3:4b+Cline 検証記録

ローカルLLMだけで自走コーディングは成立するのか。つまりAIが自分で調べ、直し、実行し、エラーが出たら再修正する。そこまで届くかを確かめました。

使ったのは手元の非力なPCと qwen3:4b です。結論から言うと、枠組みは動きました。しかし、速度と粘りはまだ足りません。さらに、途中で文字コードの事故まで起きました。

検証に使ったマシンとモデルの比較はこちらの記事にまとめています。また、前提の整理としてローカルLLM時代への準備検討を開始するもあわせてどうぞ。

検証の前提|qwen3:4b で自走コーディングは成立するか

処理速度はいまひとつです。ただし、なんとか実用ラインに乗りそうなモデルとして qwen3:4b を選びました。調整はまだ必要です。それでも、チューニングのし甲斐はありそうだと感じています。

今回の狙いは「コードを書かせること」ではありません。そうではなく、あらかじめ作業ルールを与えておけば、ルールに沿って自走コーディングできるのかを見ることです。

ローカルLLMに「作業ルール」を持たせる4つの方法

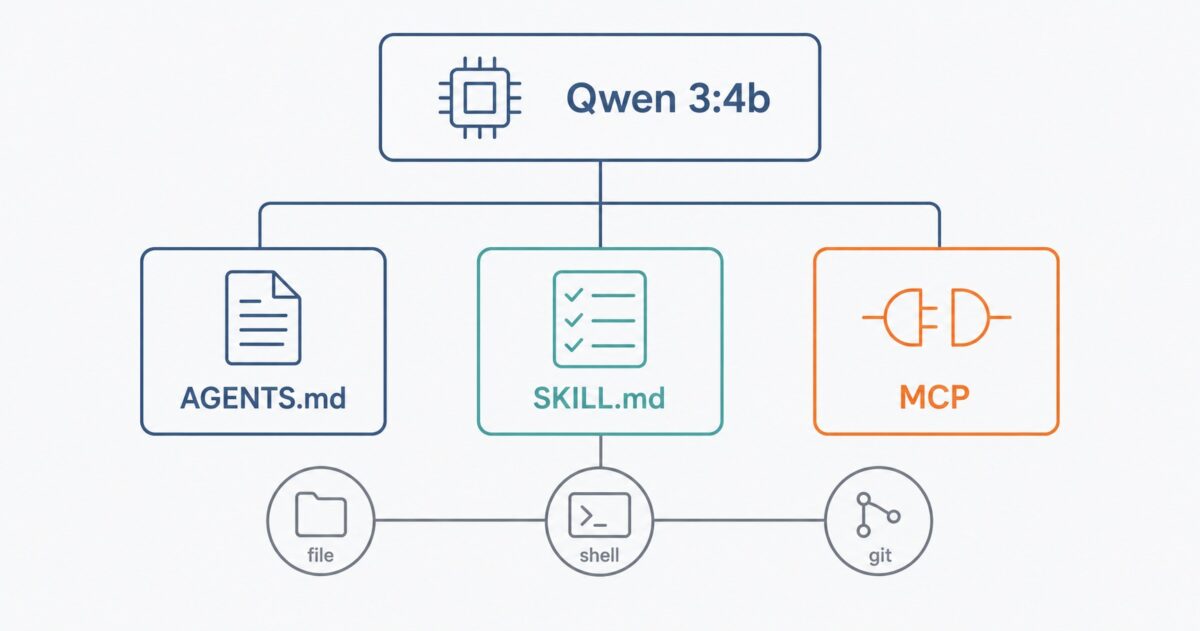
Qwen 本体に「Skill」の仕組みはありません。そこで、次の4つを組み合わせて再現します。

方法できること有効度
System Prompt常に守らせる基本ルールを設定★★★★★
Ollama Modelfileルール込みの専用モデルを作る★★★★★
AGENTS.md 等プロジェクトごとの作業ルール★★★★★
MCP/Skill的な仕組み特定作業をツールとして実行★★★★☆

例えば Ollama なら、Modelfile で専用モデルを作れます。

FROM qwen3:4b
SYSTEM """
あなたはローカル開発専用AIです。
プロジェクトディレクトリ外のファイルを変更してはいけません。
作業前に必ずプロジェクト構造を確認してください。
ファイルを変更した場合は、変更内容を確認してください。
可能な場合はテストを実行してください。
エラーが発生した場合、自分で原因を調査し、
可能な範囲で修正してから再度テストしてください。
"""
ollama create my-qwen-dev -f Modelfile
ollama run my-qwen-dev

ただし、ここが重要です。Modelfile だけでは「Skill」になりません。「Pythonを書ける」ことと、「ファイルを読んで直して実行する」ことは別です。なぜなら、後者は推論ではなくツール側の仕事だからです。実際には、MCP や Cline がその役割を担います。

実際に組んだ構成

D:\model\codes\test
 ├─ AGENTS.md          … プロジェクト固有ルール
 ├─ hello.py           … 検証対象
 └─ skills
      ├─ python\skill.md
      ├─ testing\skill.md
      └─ wordpress\skill.md

+ System Prompt(Qwen 側)
+ MCP(filesystem / terminal / git)

ポイントは考え方です。Skill をモデルに学習させない。外部の手順書として持たせる。こうすると、毎回同じ前提をプロンプトで説明せずに済みます。したがって、パラメータの小さいモデルほど恩恵が大きくなります。

検証1|AIがルールファイル自体を書き換えてしまう

最初につまずいたのは AGENTS.md でした。作業を進めるうちに、AGENTS.md が Cline 自身に書き換えられていたのです。しかも内容が変質していました。「開発の恒久ルール」ではなく、「Skillsシステムを構築する作業の指示書」になっていたのです。

例えば「今回の作業では既存のソースコードを変更しない」という一行。これはその場かぎりの制約です。しかし、恒久ルールとして残ってしまう。その結果、「hello.py を修正して」と頼んでも詰みます。

そこで AGENTS.md を一度きれいに戻しました。さらに、保護条項を明記しました。

## Skill管理
- Skillファイルは作業手順を定義する設定ファイルである。
- 通常の開発作業では SKILL.md を変更してはいけない。
- Skillの新規作成・変更・削除は、ユーザーから明示的に指示された場合のみ行う。
- ユーザーの今回限りの要求や仕様をSkillに追加してはいけない。
- AGENTS.md 自身を変更する場合も、ユーザーの明示的な許可を必要とする。
- 存在しないSkillをAIの判断だけで新規作成しない。

検証2|hello.py 修正タスクで自己修正まで届かなかった

指示は一行だけです。「hello.py を修正して、Hello と現在時刻を表示するプログラムにしてください。」

  • hello.py を変更した … ○
  • python hello.py を実行した … ○
  • エラーを検出した … ○
  • 原因を調べて修正し、再実行した … ×

実行結果はこうです。

Hello
Traceback (most recent call last):
  File "D:\model\codes\test\hello.py", line 3, in <module>
    print(datetime.now())
AttributeError: module 'datetime' has no attribute 'now'

原因は import の書き方です。import datetime と書いたうえで datetime.now() を呼んでいます。だから属性が見つかりません。正しくは次のどちらかです。

# パターンA
import datetime
print("Hello")
print(datetime.datetime.now())

# パターンB
from datetime import datetime
print("Hello")
print(datetime.now())

つまり、自走コーディングの肝であるループが途切れました。「エラー検出 → 原因調査 → 修正 → 再テスト」のうち、最後の一歩で止まったのです。

訂正|testing Skill は勝手に作られたものではなかった

検証の途中で、Cline が skills/testing/skill.md を何度も求めてきました。そのため、一時は「AIが勝手に作ろうとしている」と見なしていました。しかし、これは誤りでした。

実際には、Skills 構築の過程で自分で導入したファイルでした。実ファイルを見れば一目瞭然です。

PS D:\model\codes\test> Get-Content -Encoding UTF8 .\skills\testing\skill.md
# テストスキルルール
- テストコードの作成:unittestまたはpytestを使用し、テストケースを明確に定義する
- テストの分割:1つのテストクラスに1つのテストケースを含める
- テストデータの管理:fixtureを使用して共通のテストデータを再利用する
- テストの自動実行:pytestコマンドでテストを実行する
- エラーハンドリング:テストで例外が発生した場合は、明示的に処理する

この訂正自体が、実は大きな教訓です。つまり、AIの自己申告も、人間の記憶も、どちらもあてにならないということです。そのため、検証は必ず実ファイルで行うべきでした。

検証3|保護ルールは効いていた

保護条項を入れたあと、もう一度 Cline に作業させました。その結果は明らかに改善していました。

  • AGENTS.md を読み込んだ … ○
  • Python Skill を読み込んだ … ○
  • Skill の指示どおり python hello.py を実行した … ○
  • AGENTS.md を書き換えなかった … ○
  • SKILL.md を書き換えなかった … ○

前回はルールファイルが次々と書き換えられました。一方、今回は一切触られていません。したがって、保護ルールは小型モデルにも効くと言えそうです。

検証4|文字コード変換の指示で hello.py が壊れた

ここからが今回最大の事故です。まず、hello.py の文字コードが気になりました。そこで Format-Hex で中身を見ました。

           00 01 02 03 04 05 06 07 08 09 0A 0B 0C 0D 0E 0F
00000000   FF FE 69 00 6D 00 70 00 6F 00 72 00 74 00 20 00  .þi.m.p.o.r.t. .
00000010   64 00 61 00 74 00 65 00 74 00 69 00 6D 00 65 00  d.a.t.e.t.i.m.e.
00000020   0D 00 0A 00 70 00 72 00 69 00 6E 00 74 00 28 00  ....p.r.i.n.t.(.
00000030   22 00 48 00 65 00 6C 00 6C 00 6F 00 22 00 29 00  ".H.e.l.l.o.".).

これは「先頭にゴミがあるUTF-8」ではない

一見すると、先頭の FF FE だけがゴミに見えます。しかし、違いました。実際にはファイル全体がUTF-16 LEとして成立しています。

根拠は各文字の後ろに付いている 00 です。69 00 が i、6D 00 が m、70 00 が p。このように並べると import になります。つまり、1文字2バイトで並んでいるのです。したがって、これは間違いなくUTF-16 LEです。

なぜ「UTF-8のままだ」と思い込んだのか

混乱の原因は PowerShell の振る舞いでした。次のコマンドを見てください。

Get-Content -Encoding UTF8 .\hello.py

UTF-8 と指定しています。それなのに、中身は正しく表示されました。なぜなら、PowerShell はBOM付きファイルを読むとき、-Encoding の指定よりBOMを優先するからです。その結果、UTF-16 LEのまま正しくデコードされてしまいます。

つまり、Get-Content だけでは文字コードの確認になりません。必ず Format-Hex で実バイトを見るべきです。なお、この振る舞いは PowerShell のバージョンで差があるので、実機での確認をおすすめします。

そしてファイルは別物になった

ここで Cline にこう依頼しました。「UTF-16 LEになっている場合は、UTF-8に変換してください。」その後、先頭のバイト列はこうなりました。

EB AF AF E6 A6 BF E7 81 AD ...

これはUTF-8としては成立します。しかし、内容は日本語らしき何かです。もはや Python のコードではありません。つまり、単純な再エンコードでは説明できない状態です。

もちろん、これはランサムウェアではありません。暗号化も身代金要求もありません。それでも、体験としてはかなり近いものがありました。なぜなら、「文字コードを直すだけ」のつもりが、ファイルの中身を失う結果になったからです。

事故から導いた安全ルール

問題は指示の出し方でした。「UTF-8に変換して」だけでは、AIは「変換」と「再生成」を区別できません。だから、ここまで限定すべきでした。

hello.py の内容を変更しないでください。
文字コードだけを UTF-16 LE から UTF-8 へ変換してください。
変換前後でコードの内容が完全に一致することを確認してください。
一致しない場合はファイルを書き換えず、処理を中止してください。

さらに、AGENTS.md 側にも次のルールを追加する予定です。

  • エンコード変換は内容を変えない。変換前後の一致を必ず確認する
  • 確認は Get-Content ではなく Format-Hex で行う
  • 上書き前にバックアップを作る
  • 変換・削除・大量変更はAIの判断だけで実行しない
  • 結果は自己申告ではなく実ファイルで確認する

この事故は痛いです。しかし、得たものは大きいと思っています。なぜなら、自走コーディングとは「AIにファイルを自由に書き換えさせること」ではないとはっきり分かったからです。

現時点の結論

まず、仕組みとしては成立します。貧弱なPCとローカルLLMでも、自走コーディングの土台は作れました。実際、ルールファイルは読まれ、行動に反映されていました。

ただし、正直に書きます。この速度なら自分で手動コーディングしたほうが確実に速い。しかも、エラーの自己修正までは粘れませんでした。さらに、文字コード事故まで起きています。

したがって、現段階は「使えるかもしれない」です。「使える」ではありません。

次回やること

次は意図的に hello.py を壊します。具体的には datetime.now() に戻し、エラーを仕込んでおきます。そのうえで、Cline に一行だけ依頼します。

hello.pyを確認し、問題があればPython Skillに従って修正してください。
修正後、構文確認と実行確認まで行ってください。

合格条件は4つです。まず、AGENTS.md を書き換えないこと。次に、SKILL.md を書き換えないこと。さらに、存在しないSkillを作らないこと。最後に、hello.py だけを直して再実行まで到達することです。

そして、判定は実ファイルで行います。

Get-Content -Encoding UTF8 .\AGENTS.md
Get-ChildItem .\skills -Recurse -Filter skill.md
Format-Hex .\hello.py
python hello.py

ここまで確認して、はじめて実証成功と言えます。結果は次回の記事でご報告します。

関連記事